In den drei Artikeln zum Z3-Theorembeweiser
(1,
2,
3)
haben wir uns mit der Korrektheit des
Bresenham-Linienzeichen-Algorithmus befasst. Wer Korrektheit sagt,
muss auch Spezifikation sagen, denn korrekt kann ein Algorithmus immer
nur im Bezug auf eine eindeutige Beschreibung des gewünschten
Verhaltens sein. Als Spezifikation hatten wir in SMT-LIB2 (der Sprache
von Z3) einen simplen (aber langsamen) Referenzalgorithmus
beschrieben. Wir haben dann den komplexen (aber effizienten)
Bresenham-Algorithmus implementiert und bewiesen, dass dieser dasselbe
Verhalten aufweist wie der simple Algorithmus. Referenzalgorithmen als
Werkzeuge zur Formulierung von Korrektheitsaussagen haben den Vorteil,
dass sie oft einfach zu finden sind. Der Spezifikationsaufwand hält
sich so in Grenzen. Es geht aber auch anders. Mit mehr Aufwand findet
man manchmal elegantere Spezifikationen, die beispielsweise flexibler
sind (d.h. standhafter im Angesicht von Anforderungsänderungen) oder
den Beweisaufwand signifikant verringern.
In diesem Artikel wollen wir uns das Thema Linienzeichnen noch einmal
vornehmenen und uns dabei einzig und allein auf die Spezifikation
konzentrieren. Mit SMT-LIB2 stoßen wir dabei allerdings schnell an die
Grenzen der Ausdrucksfähigkeit. Wir verwenden deshalb für diesen
Artikel den Theorembeweiser bzw. die Programmiersprache Agda, die auf
diesem Blog schon eingeführt
wurde.
Wir werden die wichtigen Merkmale von abhängigen Typen (Dependent
Types) – dem wesentlichen Feature von Agda – in diesem Artikel so
einführen, dass man aber auch ohne Vorerfahrung folgen kann. Aber
Vorsicht: Vom Umgang mit abhängigen Typen wird man manchmal selbst
süchtig.
Wann überzeugt ein Beweis?
Eine Spezifikation, wie wir sie im folgenden ausarbeiten möchten,
besteht aus einer Menge von Aussagen. Später (nicht in diesem Artikel)
wollen wir auch Implementierungen für diese Spezifikation
schreiben. Wir wollen außerdem beweisen, dass diese
Implementierungen korrekt sind. Die Beweise, die wir hier anstreben,
sind mechanischer Art. In unserem Fall setzt uns Agda ein System mit
festen Regeln vor, das wir dann bedienen müssen, um unsere Aussagen
und Implementierungen zu formulieren und dann die Deckung zwischen den
beiden Ebenen zu beschreiben. Aber was ist eigentlich ein Beweis? Und
was bringt’s überhaupt, wenn der Beweis mechanisiert ist?
Wer sich vom Mathematikunterricht hat geistig zurichten lassen, könnte
meinen, dass ein Beweis ohnehin immer eine streng schematische, also
technische, Angelegenheit ist. Tatsächlich ist ein Beweis aber eine
soziale Sache, denn es geht dabei darum, andere Menschen von der
Geltung bestimmter Aussagen zu überzeugen. Die regelkonforme
Verwendung eines technischen Schematismus ist nicht Zweck des
Beweises, sondern Mittel zu diesem Zweck der Überzeugung. Auch die
Einführung eines allgemeinen Beweissystems erfordert zunächst
Überzeugungsarbeit. Nur jemand, der grundsätzlich davon überzeugt ist,
dass mit einem gegebenen technischen Beweissystem im Allgemeinen
korrekte Aussagen formuliert werden können, wird von einem konkreten
Beweis, der mit den Mitteln des Beweissystems hergestellt und durch
das Beweissystem als konsistent bezeugt wird, überzeugt sein.
Für diesen Artikel bedeutet das, dass ich – der Autor – erst mal ganz
grundsätzlich darlegen muss, warum bzw. inwiefern korrekte
Agda-Programme korrekte Aussagen bezeugen. Ob diese Vorarbeit gelingt,
liegt nicht in meiner Hand. Ein Leser wird am Ende einfach mit dem
Kopf schütteln können.
Propositions as Types
Viele Programmiersprachen haben ein Typsystem. Bei einem Typsystem
sind den Bestandteilen jedes Programms (Ausdrücken wie
a, 5, a + 5, \x -> x + 1 und so weiter) sog. Typen zugeordnet. Was ein Typ
genau ist, das ist gar nicht so leicht zu beantworten. Die meisten
Programmierer denken über Typen so nach wie über Mengen zulässiger
Werte. Die Haskell-Funktion, die die Länge einer Liste berechnet, hat
bspw. den Typ List a -> Int. Die Menge der zulässigen Werte für die
Eingabe der Funktion sind alle Listen egal welchen Elementtyps und die
Menge der zulässigen Werte für die Ausgabe der Funktion sind alle
Ganzzahlen. Das Typsystem bietet einerseits die Sprache, um solche
Typannotationen überhaupt auszudrücken und andererseits kommt es auch
mit einem Prüfalgorithmus, der schaut, ob ein gegebenes Programm alle
behaupteten Typen einhält. Für die Längenfunktion muss geprüft werden,
ob alle Aufrufer der Funktion wirklich nur Listen in die Funktion
reingeben und der Programmtext der Längenfunktion selbst muss
daraufhin untersucht werden, ob dieser wirklich nur Int-Werte
ausgibt.
Man kann aber auch noch mit einem anderen Blick auf Typen schauen,
nämlich so, dass ein Typ eine Aussage ist und ein Wert dieses Typs ist
ein Zeuge für diese Aussage. Diese Sichtweise kann man eigentlich auf
jedes Typsystem anwenden, aber damit man überhaupt interessante
Aussagen formulieren kann, braucht man schon ein ordentliches
Typsystem und hier kommen die berüchtigten Dependent Types ins Spiel.
Im Einführungsartikel zu
Agda
hatten wir bereits einen Datentyp für die Wertegleichheit von
natürlichen Zahlen definiert.
open import Data.Nat as ℕ using (ℕ; z≤n; s≤s)

data === (x : ℕ) : ℕ -> Set where
  refl : ((=== x) x)
Ein Typ wie === 3 3 ist dann die Aussage „Drei ist gleich
drei“. Dass das gilt, können wir mit einem entsprechenden Wert
bezeugen. Die einzige Möglichkeit, einen Wert vom Typ === a b zu
erzeugen ist, dass wir den Konstruktor refl aufrufen. Das
funktioniert hier glücklicherweise, denn 3 und 3 sind ja gleich.
3is3 : === 3 3
3is3 = refl
refl wäre kein gültiger Wert für den Typ === 3 5.
Wahr und Falsch
Bei Gleichheit mit === sind manche Aussagen wahr und manche
falsch. Wir können das Konzept von Wahrheit und Falschheit auch
universell beschreiben. Die universelle Wahrheit ist ein Typ mit einem
Konstruktor, der ganz unabhängig vom Kontext angewandt werden kann:
data Wahr : Set where
  duh : Wahr
Im Gegensatz dazu ist die universelle Falschheit ein Typ, für den es
keine Werte geben kann, weil’s nämlich gar keine Konstruktoren gibt:
data Falsch : Set where
Diese Typen gibt’s beispielsweise auch in Haskell. Wahr heißt dort
() und der Konstruktor dafür heißt ebenfalls (). Falsch in
Haskell entspricht dem Typ Void und der hat dort natürlich auch
keinen Konstruktor.
Und und/oder Oder
In der funktionalen Programmierung bauen wir kleine Programme mithilfe
von Kombinatoren zu großen Programmen zusammen. In der Logik-Sicht
entspricht dieses Vorgehen dem Zusammenstecken von simplen Aussagen zu
komplexeren Aussagen mithilfe logischer Operatoren. Einer dieser
logischen Operatoren ist das „und“. Eine Aussage A gilt und eine
Aussage B gilt. Ein Beweis für diese zusammengesetzte Aussage
erfordert das Vorhandensein eines Beweises für A und außerdem das
Vorhandensein eines Beweises für B. Das klingt nicht nur nach
Produkttyp, sondern ist auch einer – ein einfacher Record.
record Und (a : Set) (b : Set) : Set where
  constructor
    und
  field
    fst : a
    snd : b
Der Typkonstruktor Und nimmt hier keine Ganzzahlwerte entgegen
(wie === oben), sondern beliebige Typen (in Agda: Set) a und
b. Um einen Wert von solch einem Und-Typ zu konstruieren, braucht
man dann sowohl einen a-Wert als auch einen b-Wert. Damit können
wir so gehaltvolle Aussagen machen wie: Es gilt 3 = 3 und 5 = 5.
gehaltvoll : Und (=== 3 3) (=== 5 5)
gehaltvoll = und refl refl
Das Gegenstück zum Und ist das Oder und das Gegenstück zum Produkttyp
ist der Summentyp.
data Oder (a : Set) (b : Set) : Set where
  links : a → Oder a b
  rechts : b → Oder a b
Bei diesem Summentyp (der in Haskell einfach Either heißen würde)
gibt’s zwei Konstruktoren. Wer ein a hat, kann sich mit links ein
Oder a b bauen; wer ein b hat, kann sich mit rechts ein Oder a
b bauen. Damit können wir wieder eine erbauliche Aussage treffen, die
sogar durch Angabe eines entsprechend konstruierten Werts beweisbar
ist: 3 ist gleich 3 oder 5 ist gleich 99.
erbaulich : Oder (=== 3 3) (=== 5 99)
erbaulich = links refl
Natürlich können wir auch Funktionen bauen, die die Werte dieser
Aussage-Typen auseinandernehmen und neu zusammensetzen. Aus einem
Beweisobjekt für die Aussage „A und (B oder C)“ können wir
beispielsweise ein Beweisobjekt für die Aussage basteln, dass „(A und
B) oder (A und C)“. Das klingt sehr nach einer Spielart des
Distributivgesetzes und deshalb nennen wir die Funktion auch so:
distributivgesetz : {a b c : Set} → Und a (Oder b c) → Oder (Und a b) (Und a c)
Der Teil in den geschweiften Klammern ({a b c : Set}) beschreibt
drei implizite Typparameter. Die können wir erst mal ignorieren. Um
die Funktion zu implementieren, bekommen wir einen Wert des Typs Und
a (Oder b c) an die Hand. Damit können wir nicht viel machen, außer
ein Pattern-Matching auf den einzigen Konstruktor und. Der erste
Parameter dieses und ist schlicht vom Typ a. Darüber wissen wir
nichts und deshalb lassen wir den erst mal links liegen. Der zweite
Parameter ist hingegen vom Typ Oder b c und da wissen wir, dass es
zwei Konstruktoren geben kann. Die einzige Möglichkeit zum
Weitermachen besteht also in einer Fallunterscheidung – wieder in Form
von Pattern-Matching. Mit dem a-Wert und dem b-Wert im ersten Fall
können wir dann ein Und a b zusammenbauen und das mit links in ein
Oder (Und a b) (Und a c) überführen. Im zweiten Fall haben wir ein
a und kein b aber dafür ein c. Auch das reicht aus, um ein
Oder (Und a b) (Und a c) zu basteln.
distributivgesetz (und a (links b)) = links (und a b)
distributivgesetz (und a (rechts c)) = rechts (und a c)
Der hier vorkommende Pfeil (->) für die Konstruktion von
Funktionstypen sieht nicht nur so aus wie ein Implikationspfeil für
logische Aussagen, sondern er wirkt auch so. Ein „Aus A folgt B“
können wir auch lesen als ein „Gib mir einen Beweis für A und ich gebe
dir einen Beweis für B“. Genau das haben wir gerade eben gemacht.
Einer für alle
Der Implikationspfeil kann sogar noch mehr. In der Definition von
distributivgesetz hab ich ja anfangs galant unterschlagen, dass da
noch ein {a b c : Set} steht. Diese impliziten Parameter machen den
Typ von distributivgesetz zu einem abhängigen Typ, denn wir führen
vorne Werte a, b und c ein, die wir später in der Konstruktion
weiterer Teile des Typs verwenden (bspw. Und a b). Die geschweiften
Klammern führen einfach nur dazu, dass Agda versucht, diese Typen
automatisch zu finden, ohne dass wir sie jedes mal explizit angeben
müssen. Als Teil eines logischen Ausdrucks genommen, können wir das
auch lesen als „Für alle Aussagen a, b, und c gilt: …“ Dieses
Für-Alle, was in der Prädikatenlogik mit einem eigenen Symbol – dem
Allquantor ∀ – gewürdigt wird, ist in einem Dependent-Type-System
einfach eine beiläufige Konsequenz.
Ganz ähnlich verhält es sich mit dem Gegenspieler zum Allquantor, dem
Existenzquantor ∃. Eine Aussage wie „Es existiert eine natürliche
Zahl, die eins größer als 5 ist“ können wir in zwei Schritten
beweisen: Zunächst müssen wir einen konkreten Wert angeben –
beispielsweise die 6 – und dann müssen wir für diesen Wert beweisen,
dass die Aussage gilt. Das klingt doch wieder nach Produkttyp –
allerdings brauchen wir einen Produkttyp, bei dem der rechte Teil vom
linken abhängt. Diese Abhängigkeit haben wir in der Definition des
Und oben nicht vorgesehen. Wir können diesen Fehler beheben:
record Existiert (a : Set) (b : a → Set) : Set₁ where
  constructor
    make
  field
    fst : a
    snd : b fst
Diese Record-Definition benennt einen Typ-Konstruktor
Existiert. Dieser nimmt einen beliebigen Typ a als ersten
Parameter und dann eine Funktion b, die einen Wert dieses Typs in
eine Aussage (Set) verwandelt. Dieses b können wir auch ansehen
als Aussage, die noch eine Lücke enthält. Diese beiden Typparameter
kann man als Verwender ganz frei angeben – sprich: man kann fast
beliebige Existenzaussagen treffen. Ob diese Aussagen wahr sind,
entscheidet sich dann daran, ob man vom entsprechenden Typ auch einen
Wert erzeugt bekommt. Das geht, indem man den Wertkonstruktor make
aufruft und diesem zwei Werte übergibt. Der erste Wert (fst) ist
zunächst ein beliebiger Wert vom Typ a. Der zweite Wert hat’s dann
allerdings in sich: gefordert ist ein Wert von dem Typ, der entsteht,
wenn wir die abstrahierte Aussage b auf das konkrete fst (also den
ersten Wert) anwenden.
Jetzt können wir aussagen, dass es einen Nachfolger für die Zahl 5
gibt. Der Beweis dazu muss den konkreten Nachfolger (natürlich die 6) benennen:
eins-größer-5 : Existiert ℕ (λ x → === x (5 ℕ.+ 1))
eins-größer-5 = make 6 refl
Agda Standard Library
All diese Typen finden sich auch in der Agda-Standardbibliothek. Da
Agda gern die volle Bandbreite von Unicode verwendet, sind die
entsprechenden Typkonstruktoren sogar recht nah an dem, was man in der
Prädikatenlogik kennen gelernt hat.
Die Gleichheit, die wir oben mit === und refl selbst gebaut haben,
heißt in der Standardbibliothek PropositionalEquality mit dem
Infix-Typkonstruktor _≡_ und dem gleichnamigen Konstruktor refl.
open import Relation.Binary.PropositionalEquality using (_≡_; refl; module ≡-Reasoning)
Das Und ist in Agda _×_, das Existiert ist ein waschechtes ∃
und der Konstruktor für beide Typen ist das Komma (,).
open import Data.Product using (_×_; _,_; ∃)
Das Oder mit den Konstruktoren links und rechts ist in Agda ⊎
mit den Konstruktoren inj₁ und inj₂.
open import Data.Sum using (_⊎_; inj₁; inj₂)
Der triviale Wahr-Typ heißt in Agda ⊤ und wird „Top“
ausgesprochen. Der Konstruktor ist tt.
open import Data.Unit using (⊤; tt)
Unser Falsch heißt in Agda ⊥ und das wird „Bottom“ ausgesprochen.
open import Data.Empty using (⊥)
Da ∀ in Agda geschickterweise ein Synonym für
Funktionstypenkonstruktion ist, können wir Aussagen so
zusammenbasteln, dass sie schon fast wie Prädikatenlogik aussehen.
vorgänger : ∀ x → x ≡ 0 ⊎ ∃ λ y → x ≡ 1 ℕ.+ y
vorgänger ℕ.zero = inj₁ refl
vorgänger (ℕ.suc x) = inj₂ (x , refl)
Das Prinzip ist dasselbe.
Ich hoffe, dieser kurze Einblick in die Mechanismen von Dependent
Types in Agda reicht aus, um zwei Dinge zu plausibilisieren:
- Mit Agda-Typen lassen sich ziemlich viele logische Zusammenhänge
ausdrücken.
- Diese logischen Zusammenhänge erhalten Geltung durch die Angabe von
passenden Beweisobjekten. Logische Aussagen, die intuitiv falsch
erscheinen, werden sich in Agda nicht beweisen lassen. Ob man für
die Aussagen, die intuitiv wahr erscheinen, auch wirklich einen
Beweis findet, das liegt dann immer noch beim
Softwareentwickler. Automatisch (wie bspw. mit Z3) geht das in Agda
jedenfalls nicht.
Punkte, Vektoren, Linien, Segmente
Nach dieser kurzen Einführung in Dependent Types wollen wir uns jetzt
dem Zeichnen von Linien zuwenden. Um Linien zeichnen zu können,
brauchen wir natürlich eine Leinwand. Koordinaten auf der Leinwand
können mithilfe von Punkten bestehend aus zwei reellen Zahlen – eine
für die x-Koordinate und eine für die y-Koordinate – benannt
werden. Reelle Zahlen sind leider ziemlich hakelig, deshalb begrenzen
wir uns hier auf die rationalen Zahlen. Die sind auch schon in der
Agda-Standardbibliothek eingebaut:
module _ where

open import Data.Rational as ℚ using (ℚ; mkℚ; 0ℚ; 1ℚ; ½)
Mit den rationalen Zahlen definieren wir uns Punkte mithilfe einer
Record-Definition:
record Point : Set where
  constructor
    make-point
  field
    x : ℚ
    y : ℚ
In dieser zweidimensionalen Geometrie sind solche Punkte auch synonym
mit Vektoren und mit Vektoren kann man rechnen. Das werden wir später
noch im großen Stil ausnutzen. Die folgenden Definitionen könnten sich
alle in einer beliebigen Geometrie-Bibliothek finden.
Vector : Set
Vector = Point
Zwei Vektoren addieren wir, indem wir die einzelnen Komponenten addieren.
_+_ : Vector → Vector → Vector
make-point dx₁ dy₁ + make-point dx₂ dy₂ = make-point (dx₁ ℚ.+ dx₂) (dy₁ ℚ.+ dy₂)
Vektoren können negiert werden.
-_ : Vector → Vector
- (make-point dx dy) = make-point (0ℚ ℚ.- dx) (0ℚ ℚ.- dy)
Minus ist dann einfach Addition und Negation.
_-_ : Vector → Vector → Vector
v1 - v2 = v1 + (- v2)
Vektoren können skaliert werden.
scale : ℚ → Point → Point
scale s (make-point dx dy) = make-point (s ℚ.* dx) (s ℚ.* dy)
Vektoren haben eine Länge; das ist der Abstand zwischen (0, 0) und dem
Endpunkt des Vektors. Solche Abstände kann man auf vielerlei Arten
angeben; meistens nutzt man die euklidische Distanz. Für deren
Berechnung muss man allerdings Wurzeln ziehen und das würde richtige
reelle Zahlen erfordern. Wir sprechen deshalb im folgenden immer über
die quadrierte Länge bzw. quadrierte Abstände.
vlen² : Vector → ℚ
vlen² (make-point dx dy) = dx ℚ.* dx ℚ.+ dy ℚ.* dy
Wer Linien zeichnen will, muss diese erst modellieren. Streng genommen
möchte ich gar keine Linien malen, sondern sog. Liniensegmente. Diese
haben einen Start- und einen Endpunkt. Auch für solche Liniensegmente
können wir einen Vektor bestimmen, der die Linie entlang zeigt.
record LineSegment : Set where
  constructor
    make-line-segment
  field
    start : Point
    end : Point

line-segment-start : LineSegment → Point
line-segment-start = LineSegment.start

line-segment-end : LineSegment → Point
line-segment-end = LineSegment.end

line-segment-vector : LineSegment → Vector
line-segment-vector (make-line-segment s e) = e - s
In der echten Welt sind Leinwände in Höhe und Breite begrenzt. Wir
befinden uns hier aber in der abstrakten Welt der puren Gedanken und
da können wir uns einfach eine unendliche Leinwand bauen. Leinwände
sind also einfach synonym zum Typ Point. Unendlichkeit mag im
ersten Moment abschreckend wirken, aber tatsächlich ist die unendliche
Leinwand deutlich „einfacher“ als jede begrenzte Leinwand, denn bei
der unendlichen müssen wir im Folgenden nicht ständig
Fallunterscheidungen machen, ob wir mit unserem Stift jetzt gerade
über die Grenzen hinausmalen oder nicht.
Die Linie ist unser Sujet, doch was ist das Medium? Wir könnten wieder
den Pixelbildschirm heranziehen, aber in diesem Artikel wollen wir mit
etwas anderem beginnen. Die ursprüngliche Erfindung des
Bresenham-Algorithmus fand in einer Zeit statt, als Computer noch
keine Pixel-Bildschirme hatten. Stattdessen kamen Linienplotter zum
Einsatz. Ein Linienplotter malt auf Papier. Das Papier wird auf einer
Rolle entweder nach vorn oder hinten gezogen. Ein Stift ist an einer
Aufhängung darüber angebracht und kann entweder nach links oder
nach rechts bewegt werden. Ein Linienzeichenprogramm besteht dann aus
der initialen Position des Stifts und einer Menge diskreter
Schritte. In jedem Schritt wird entweder die Rolle oder der Stift
bewegt. Das können wir ganz einfach modellieren.
data Step : Set where
  N : Step
  E : Step
  S : Step
  W : Step

open import Data.List as List using (List; []; _∷_)

record Program : Set where
  constructor
    make-program
  field
    start : Point
    steps : List Step
Wann ist jetzt solch ein Program ein korrektes Linienzeichenprogramm
für eine gegebene Ideallinie? Bresenham – der Autor des entsprechenden
Papers – macht darüber gar keine Angaben. Wir müssen das leider selbst
bestimmen. Vage gesprochen sollte wohl die Linie, die das Program
zeichnet möglichst nah an der Ideallinie verlaufen. Was heißt
„möglichst nah“? Vielleicht wollen wir die Menge der Punkte
maximieren, in denen die Ideallinie und die Programmlinie exakt
übereinstimmen? Ob diese Präzision wirklich unsere Intuition trifft,
können wir mit einem kleinen Beispiel – sozusagen einem Unit Test für
unsere Spezifikation – ausprobieren.
Die erste Stichprobe scheint unsere Präzisierung zu bekräftigen:
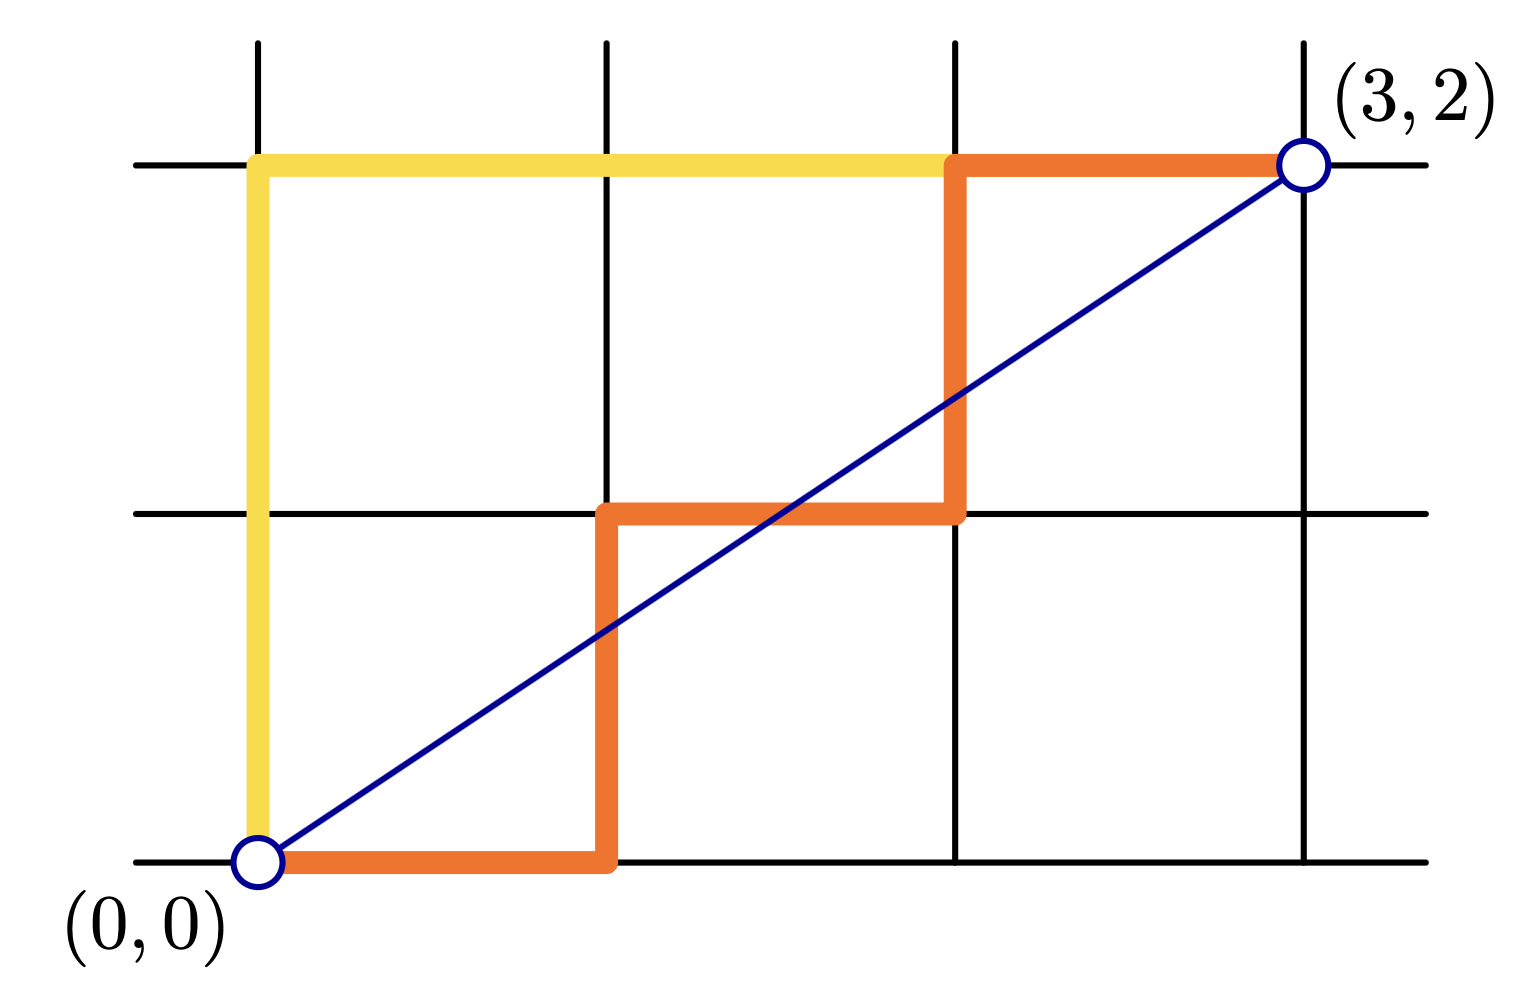
Die Ideallinie verläuft vom Ursprung zum Punkt (3, 2). Die
wahrscheinlich beste Näherung ist hier in orange gezeichnet und trifft
die Ideallinie im Anfangspunkt, im Endpunkt und dazwischen in drei
weiteren Punkten. Die gelbe Linie ist intuitiv als gute Approximation
zu verwerfen. Sie trifft sich mit der Ideallinie auch nur in zwei
Punkten.
Doch bei einer Linie, die vom Ursprung nach (1, 1) verläuft, wird die
beste Programmlinie immer nur in maximal zwei Punkten mit der
Ideallinie übereinstimmen. Das tut aber auch eine Programmlinie, die
völlig abwegig verläuft:
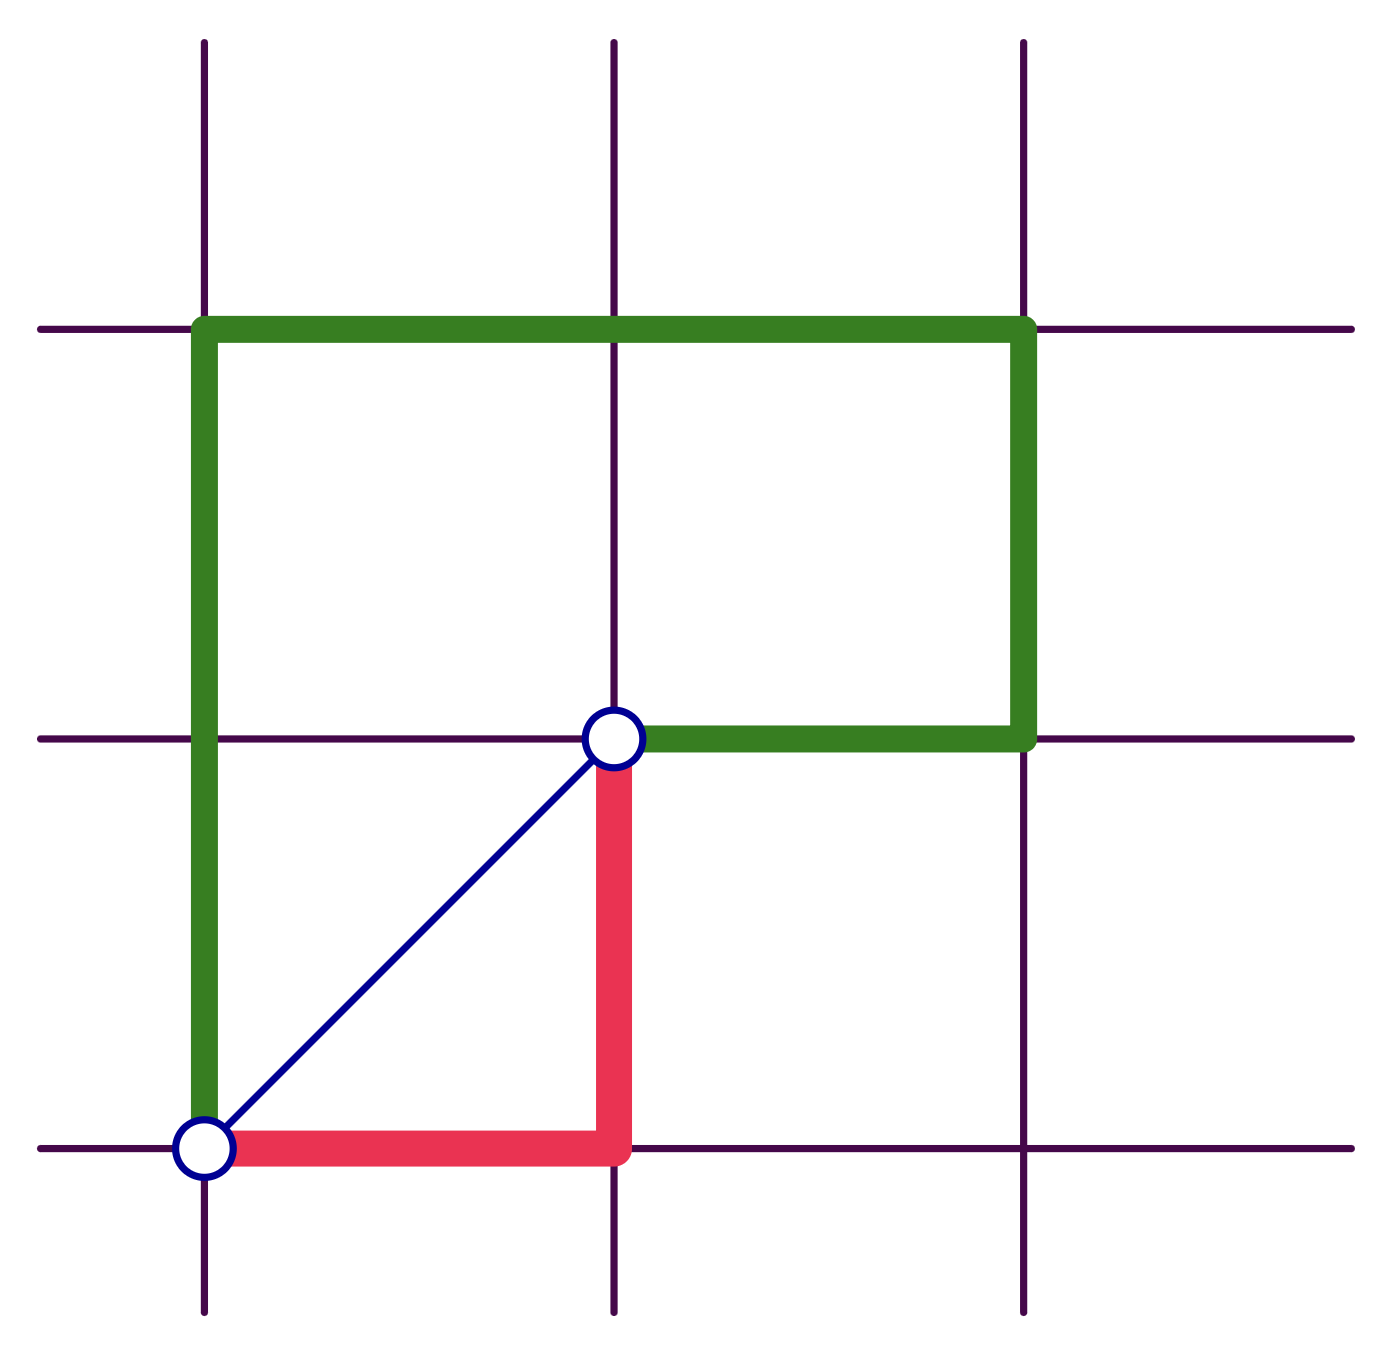
Unsere Intuition würde niemals erlauben, dass wir die grüne und die
rote Linie als ebenbürtige Näherungen für die Ideallinie ansehen.
Das heißt also, dass es nicht allein darum gehen kann, die Punkte zu
betrachten, die exakt übereinstimmen. Viel eher sollten wohl alle
Zwischenpunkte möglichst nah bei der Ideallinie liegen. Den Abstand
eines Punktes von einer Linie ist mit der Länge der Normalen
wohldefiniert. Doch auch damit ist es noch nicht getan. Immerhin haben
wir nicht nur eine solche Normale, sondern ziemlich viele. Um die Güte
solcher Normalenmengen zu bestimmen, müssen wir uns entscheiden, ob
wir beispielsweise den Durchschnittswert, die Gesamtsumme oder
vielleicht nur das Maximum verwenden wollen. Doch auch mit Beantwortung
dieser Frage sind wir noch nicht fertig. Egal welche Aggregatsfunktion
wir heranziehen, die „beste“ Programmlinie wird dann immer die sein,
die einfach auf einem Punkt stehen bleibt. Auch dagegen muss sich
unsere Spezifikation irgendwie absichern …
The medium and the message
Details über Details sind also zu spezifizieren und das allein, wenn
wir uns eine einzige Art des Mediums – den Linienplotter – und eine
einzige Art des gemalten Objekts – Liniensegmente – vornehmen. In
einer ausgewachsenen Software werden wir wahrscheinlich auch andere
Objekte zeichnen wollen. Schon ein Linienzug – mehrere Liniensegmente
hintereinander – wirft wieder neue Fragen auf. Für einen gegebenen
Punkt im Raum gibt’s dann schon mal gar nicht mehr die eine Normale,
deren Länge wir minimieren wollen. Ebenso wäre es
wünschenswert, nicht nur mit Linienplottern zu malen, sondern auch mit
Pixelbildschirmen, Vektordisplays, CNC-Fräsen etc. Anstatt uns für
jede Kombination von Medium und Objekt aufs neue den Kopf über die
Details zu zerbrechen, vollführen wir das bekannte Manöver aus der
funktionalen Programmierung: Wir abstrahieren. Wir fragen uns: Was
haben alle Medien gemeinsam und was haben alle Objekte gemeinsam?
Beginnen wir beim Liniensegment. Wie ein solches repräsentiert
werden kann, steht in der Record-Definition oben: Eine Linie besteht
aus einem Anfangs- und aus einem Endpunkt. Die Bedeutung, sprich das
Wesen, eines Liniensegments haben wir bisher allerdings nur implizit
behandelt. Ein Liniensegment, das sind nicht bloß zwei Punkte, sondern
das sind zwei Punkte und alle Punkte, die auf direktem Wege zwischen
diesen beiden Punkten liegen. Diesem Satz können wir bereits
ablauschen, dass es sich bei der Bedeutung von Liniensegmenten um
Punktemengen handelt. Mengen lassen sich wiederum auf vielfältigste
Art repräsentieren – als Listen, Bäume, Bitvektoren, oder als
sog. charakteristische Funktionen. Die charakteristische Funktion
einer Menge zeigt für jedes Element an, ob dieses in der Menge liegt
oder nicht. Die charakteristische Funktion ist die allgemeinste
Repräsentation von Mengen; deshalb wählen wir diese als den Typ für
die Bedeutungsebene.
Wir könnten die charakteristischen Funktionen in den Bool-Typ
abbilden lassen, also boolesche Prädikate definieren. Noch besser für
die weitere Spezifikationsarbeit eignen sich in Agda (und ähnlichen
Sprachen) die sog. Typlevel-Prädikate. Ein Typlevel-Prädikat als
Repräsentation einer Punktemenge bildet jeden Punkt ab auf einen
Typ.
Image : Set₁
Image = Point → Set
Der Typ gibt nicht nur an, ob der Punkt in der entsprechenden
Punktemenge liegt oder nicht, sondern er gibt sogar an, warum er
Teil der Punktemenge ist. Eine solche Begründung ist dann einfach ein
Wert des gegebenen Typs. Ein triviales Beispiel für ein solches Bild
ist die komplett vollgemalte, schwarze Leinwand.
black : Image
black p = ⊤
Zur Erinnerung: ⊤ ist der Typ für die universelle Wahrheit. Damit ist
der Beweis dafür, dass an der Koordinate (0, 0) ein schwarzer Punkt
ist, ganz leicht zu finden.
black-is-black-at-00 : black (make-point 0ℚ 0ℚ)
black-is-black-at-00 = tt
Der Konstruktor tt erzeugt einfach einen Wert vom Typ ⊤. Mehr ist
hier nicht nötig.
Weniger trivial wäre ein Bild mit einer schwarzen Linie, die die
Geradenfunktion f(x)=x nachzeichnet:
f : Image
f (make-point x y) = x ≡ y
Wir sagen wortwörtlich: Ein Punkt (x, y) liegt im Bild f, wenn
gezeigt werden kann, dass x ≡ y gilt. Für den Punkt (1, 1) trifft das zu:
_ : f (make-point 1ℚ 1ℚ)
_ = refl
Mit Image können wir jetzt auch endlich beschreiben, was ein
LineSegment eigentlich bedeutet. Ein Liniensegment ist ja ein Bild
und zwar genau das, wo die Punkte, die sich auf dem Liniensegment
befinden, angemalt sind. Und das heißt: ein Punkt ist entweder
angemalt, wenn es der Start- oder der Endpunkt des Liniensegments ist
oder eben ein Punkt dazwischen. Einen Punkt p „dazwischen“ können
wir ansteuern, wenn es ein Skalar s : ℚ gibt, mit dem wir ausgehend
vom Startpunkt die entsprechende Skalierung des Linienvektors
entlanglaufen können und dann am Punkt p ankommen. Formal:
line-segment-image : LineSegment → Image
line-segment-image l p
  = ∃ λ (s : ℚ) →
        (line-segment-start l) + (scale s (line-segment-vector l)) ≡ p
Das ∃ λ (s : ℚ) → ... ist der abhängige Produkttyp, wie wir ihn oben eingeführt haben.
Wir können für diese Definition von line-segment-image ein paar
Unit-Tests schreiben, also Beispiele durchprobieren. Das
Liniensegment, das vom Punkt (0, 0) zum Punkt (½, ½) verläuft, sollte
auf jeden Fall den Punkt (0, 0) enthalten:
ls1 : LineSegment
ls1 = make-line-segment (make-point 0ℚ 0ℚ) (make-point ½ ½)

_ : line-segment-image ls1 (make-point 0ℚ 0ℚ)
_ = 0ℚ , refl
Ein Wert vom Typ line-segment-image ls1 (make-point 0ℚ 0ℚ) – also
ein Beweis für die Aussage, dass (0, 0) im Bild vom Liniensegment
ls1 angemalt ist – ist ein Tupel. Links ins Tupel gehört der
Skalarwert: Mit welchem Wert müssen wir den Linienvektor skalieren, um
ausgehend vom Startpunkt bei (0,0) am Punkt (0,0) rauszukommen? Der
gesuchte Wert ist offensichtlich die Null. Rechts gehört dann ein
Beweis für die Gleichheit. Da hier alles „per definitionem“ aufgelöst
werden kann, ist der Beweis für die Gleichheit einfach der Konstruktor
refl.
Analog können wir beweisen, dass der Punkt (½, ½) auf der Linie
liegt. Dann müssen wir den Linienvektor mit 1 skalieren.
_ : line-segment-image ls1 (make-point ½ ½)
_ = 1ℚ , refl
Was nicht funktionieren sollte, ist zu beweisen, dass der Punkt (1, 1) auf dem Liniensegment liegt. Geht aber:
2ℚ = 1ℚ ℚ.+ 1ℚ

_ : line-segment-image ls1 (make-point 1ℚ 1ℚ)
_ = 2ℚ , refl
Wir können den Linienvektor mit 2 multiplizieren und landen dann bei
(1, 1). Ein Liniensegment soll aber nur die Punkte zwischen dem
Start- und dem Endpunkt enthalten. Unsere Definition von
line-segment-image hat einen Fehler. Wir dürfen nicht beliebig
skalieren, sondern nur mit einer Zahl zwischen 0 und 1. Die fehlerfreie Definition lautet also:
line-segment-image' : LineSegment → Image
line-segment-image' l p
  = ∃ λ (s : ℚ) →
        (0ℚ ℚ.≤ s) × (s ℚ.≤ 1ℚ) ×
        (line-segment-start l) + (scale s (line-segment-vector l)) ≡ p
Das × ist der normale (nicht-abhängige) Produkttyp-Konstruktor. Wir
können den hier als „und“ lesen.
Dass Spezifikationen auch Bugs enthalten können und zwar auch solche,
die man nicht auf Anhieb als solche erkennt, ist eine schlechte
Nachricht für alle, die den menschlichen Intellekt komplett aus der
Programmiererei vertreiben wollen. So können große Sprachmodelle
beispielsweise durchaus dabei helfen, für gegebene Spezifikationen
sowohl effiziente Algorithmen zu finden als auch deren Korrektheit zu
beweisen. Die Entscheidung darüber, ob die Spezifikation selbst
allerdings überhaupt dem entspricht, was man will, das kann einem
keiner abnehmen.
Jetzt wissen wir, was Liniensegmente bedeuten, nämlich
Punktemengen. Wenden wir uns nun dem Medium zu und fragen: Was ist es
eigentlich, was ein Program darstellt? In weiser Voraussicht haben
wir den Typ oben für die Punktemengen bereits Image genannt. Ein
Linienplotter malt natürlich auch Bilder. Ist es womöglich so, dass
auch die Bedeutung eines Program bloß eine Menge von Punkten ist?
Fürwahr!
move : Point → Step → Point
move (make-point x y) N = make-point x (y ℚ.+ 1ℚ)
move (make-point x y) E = make-point (x ℚ.+ 1ℚ) y
move (make-point x y) S = make-point x (y ℚ.- 1ℚ)
move (make-point x y) W = make-point (x ℚ.- 1ℚ) y

program-image' : Point → List Step → Image
program-image' position [] p = ⊥
program-image' position (step ∷ program) p
  = line-segment-image' (make-line-segment position next-position) p
    ⊎ (program-image' next-position program p)
  where
    next-position = move position step

program-image : Program → Image
program-image (make-program start []) p = p ≡ start
program-image (make-program start steps) = program-image' start steps
Der interessante Teil dieser Definition steckt in
program-image'. Das Bild, das für einen Startpunkt position und
eine leere Liste von Schritten zurückgegeben wird, ist genau das leere
Bild. Wenn’s allerdings noch einen Schritt zu laufen gibt, dann ist
ein gegebener Punkt p genau dann auf der Linie, wenn er auf dem
Liniensegment zwischen position und next-position liegt oder
(⊎) wenn das restliche Programm sagt: Ja, dieser Punkt p, der
liegt auf dem Bild, das ich zeichne. Das ⊎ ist der Typ-Konstruktor für
den freien Summentyp.
Für das Programm, das vom Ursprung erst einmal nach rechts und dann
einmal nach oben geht, können wir beweisen, dass der Punkt (½, 0) auf
dem entsprechenden Bild liegt. Und zwar liegt der Punkt ja auf dem
ersten der beiden gezeichneten Liniensegmente. Mit inj₁ erzeugen wir
einen Wert vom entsprechend verlangten Summentyp. Der Teilbeweis dafür, dass
der Punkt (½, 0) auf dem ersten Liniensegment liegt, besteht wie oben
aus der Angabe eines Skalars, einem Beweis, dass dieser Skalar größer
oder gleich 0 ist, einem Beweis, dass dieser Skalar kleiner oder
gleich 1 ist und einem Beweis der damit konstruierten
Gleichheitsaussage.
open import Data.Integer as ℤ using () renaming (_*_ to _*i_)

0≤½ : 0ℚ ℚ.≤ ½
0≤½ = ℚ.*≤* (ℤ.+≤+ z≤n)

½≤1 : ½ ℚ.≤ 1ℚ
½≤1 = ℚ.*≤* (ℤ.+≤+ (s≤s z≤n))

_ : program-image
      (make-program
        (make-point 0ℚ 0ℚ)
        (E ∷ N ∷ []))
      (make-point ½ 0ℚ)
_ = inj₁ (½ , 0≤½ , ½≤1 , refl)
Jetzt haben wir definiert, dass sowohl Liniensegmente, als auch
Linienplotter-Programme einfach bloß Punktemengen sind. Bei Nacht sind
alle Katzen grau. Das hat den Vorteil, dass wir für die Definition der
Korrektheit zwischen Ideallinie und Linenprogramm jetzt nicht mehr so
viele Details beachten müssen, weil wir gar nicht mehr so viele
Details beachten können. Außerdem brauchen wir gar nichts mehr
selbst zu erfinden. Eine kurze Recherche zum Thema Ȁhnlichkeit von
Punktemengen« ergibt, dass es da eine Hand voll Standardmetriken
gibt. Als passende erscheint die Hausdorff-Distanz. Bei dieser assoziiert
man zu jedem Punkt in der einen Menge einen entsprechenden Punkt in
der anderen Menge und zwar den mit dem geringsten
(Punkte-)Abstand. Von all diesen Abständen ist dann der größte die
Hausdorff-Distanz.
Wenn wir in Agda sagen wollen, dass zwei Bilder ähnlich genug
zueinander sind, dann hängt das von einer Grenze ab, die wir einfach
als Parameter dazugeben:
distance² : Point → Point → ℚ
distance² p1 p2 = vlen² (p1 - p2)
image-similar : ℚ → Image → Image → Set
image-similar ϵ² img1 img2 = (∀ p → img1 p → ∃ λ p' → img2 p' × distance² p p' ℚ.≤ ϵ²)
×
(∀ p → img2 p → ∃ λ p' → img1 p' × distance² p p' ℚ.≤ ϵ²)
image-similar ist natürlich auch wieder ein Typlevel-Prädikat. Für
eine gegebene Grenze ϵ² und zwei Bilder img1 und img2 können wir
den Typ wie folgt lesen: Für alle Punkte p, die in der Menge img1
liegen, existiert ein entsprechender Punkt p', der in der Menge
img2 liegt und der von p eine Punktedistanz kleiner-gleich ϵ²
hat. Außerdem (×) gilt das ganze noch andersherum, also mit img1
und img2 vertauscht.
Fazit
Wir haben jetzt formal spezifiziert:
- Die Bedeutung von Liniensegmenten sind Punktemengen (
Image). Ein
Liniensegment beschreibt genau die Punkte zwischen Start- und
Endpunkt, d.h. die Punkte, die mit einem Skalar mit Länge zwischen 0
und 1 vom Startpunkt aus erreicht werden können.
- Die Bedeutung von Programmen eines Linienplotters sind auch nur
Punktemengen. Ein Programm zeichnet ausgehend vom Startpunkt eine
Menge aufeinanderfolgender Liniensegmente.
- Was heißt es, dass eine beliebige Näherung (vom Typ
Image) ein
gegebenes ideales Bild (ebenfalls vom Typ Image) gut approximiert?
Das haben wir auf die Hausdorff-Metrik zwischen den Punktemengen
zurückgeführt.
Der Umstand, dass die Beschreibung der Korrektheit von Näherungen
nicht von Liniensegmenten oder Linienplottern abhängt sondern
lediglich vom abstrakten Image, macht die Spezifikation einwandfrei
erweiterbar auf viele andere geometrische Figuren und viele andere
Malwerkzeuge.
Ordentliche Spezifikationen sind notwendig für die Implementierung
korrekter Software. Die Implementierungsarbeit muss aber dann auch
folgen. Wie das funktionieren kann, werden wir in einem der nächsten
Artikel sehen.